Operationele efficiëntie
Waarom AI in dealernetwerken betrouwbare data nodig heeft
- Gepubliceerd
- Leestijd
- 4 min lezen
- Onderwerpen
- Operationele efficiëntie · Klantervaring · Digitale retailstrategie · Marketingautomatisering
Uw AI is slechts zo goed als de informatie eronder. En in automotive is die informatie zelden zo schoon, gekoppeld of actueel als de dashboards suggereren.
Aflevering 1 tot en met 4 gingen over klantreizen, governance, mensen en de risico’s van overautomatisering. Deze aflevering gaat over het onderdeel waar iedereen het over heeft maar weinigen eerlijk aanpakken: het datafundament. Niet de geïdealiseerde architectuurschema’s. De echte beperkingen binnen dealergroepen en importeurs (NSC’s).
Als u ooit hebt geprobeerd automatisering te bouwen op vijf DMS-instanties, drie CRM-gewoonten en tien jaar aan inconsistente klant-ID’s, dan weet u al dat deze aflevering nodig is.
Hoe automotive data er werkelijk uitziet
In de meeste sectoren vertragen dataproblemen de zaak. In automotive breken ze die.
Servicehistorie verspreid over systemen. Dubbele klanten die naast elkaar bestaan. Voertuigen die niet aan eigenaren te koppelen zijn. Einddata van financieringen die alleen op papier staan. Adviseurs die op intuïtie werken omdat de systemen het oneens zijn.
AI lost daar niets van op. Ze legt het bloot.
Wanneer de onderliggende data versnipperd is, begint AI:
- de verkeerde klanten te prioriteren
- upgradekansen aan te dragen die niet echt zijn
- herinneringen te sturen voor werk dat al is uitgevoerd
- signalen te missen die mensen direct zouden opmerken
Het resultaat is niet alleen inefficiëntie. Het is erosie van vertrouwen.
Een scenario dat we vaak zien
Een dealergroep lanceert berichten voor voorspellend onderhoud. Het model is getraind, de workflow is gebouwd en de eerste golf gaat de deur uit.
Binnen een week merken adviseurs verwarde klanten op. Mensen die al in de werkplaats zijn geweest. Mensen die hun auto zes maanden geleden hebben verkocht. Mensen die gisteren online hebben geboekt en vandaag een nieuwe herinnering ontvingen.
Er is niets mis met de AI. Ze voorspelt accuraat op basis van de data die ze ziet.
Het probleem is de data.
Dit is het moment waarop de meeste organisaties beseffen dat ze geen technologieprobleem hebben. Ze hebben een probleem met hun datafundament.
De drie datafundamenten die ertoe doen (en de enige drie)
U hebt geen perfect datawarehouse nodig. U hebt geen migratie van tien maanden nodig. U hebt drie dingen nodig die AI in automotive werkelijk bruikbaar maken.
1. Een stabiele identiteit voor klanten en voertuigen
Als u niet betrouwbaar kunt zeggen wie iemand is en welk voertuig hij bezit, wordt al het andere giswerk. Hier faalt de meeste automatisering. Niet door de logica, maar door records die niet op elkaar aansluiten.
2. Gebeurtenisdata die de werkelijkheid weerspiegelt
Een servicebeurt. Een afgewezen reparatie. Een gemiste afspraak. Een financieringscontract dat bijna afloopt. Dit zijn niet zomaar datapunten. Het zijn signalen voor timing. Zonder accurate gebeurtenisdata gaat AI op het verkeerde moment af.
3. Een datastroom die snel genoeg bijwerkt
Dagelijkse batchupdates zijn niet genoeg voor klantgerichte AI. Als de klant om 10:02 boekt en om 10:03 een herinnering ontvangt, hebt u een vertrouwensprobleem gecreëerd. Gegevens moeten worden bijgewerkt op het moment dat de klant iets doet, niet in het tempo van verouderde systemen.
Deze drie fundamenten maken het verschil tussen AI die intelligent aanvoelt en AI die losgekoppeld aanvoelt.
Een instrument dat u direct kunt gebruiken: de Data Reality Check
Dit duurt tien minuten en vertelt u of uw organisatie klaar is voor betekenisvolle automatisering.
Stel drie vragen:
1. Kunnen we een klant en zijn voertuig uniek identificeren in alle systemen?
Als het antwoord “meestal” of “dat hangt van de vestiging af” is, hebt u werk te doen.
2. Worden onze belangrijkste gebeurtenissen automatisch, accuraat en snel gesynchroniseerd?
Boekingen, facturen, reparatiegoedkeuringen, statuswijzigingen.
3. Hoeveel handmatige correcties voeren adviseurs per week uit?
Als adviseurs de data handmatig repareren, erft uw AI die fouten.
De meeste organisaties ontdekken hetzelfde: de blokkades zijn niet technisch. Ze zijn operationeel.
Waar WEBSOLVE past
WEBSOLVE vervangt de kernsystemen niet. Het brengt ze op één lijn.
Tools als Radar, Pitstop, Reach en Flows werken bovenop uw bestaande DMS- en CRM-landschap, maar creëren een consistente laag waarin timing, identiteit en gebeurtenissen eindelijk kloppen.
Dat betekent dat uw automatisering niet afhankelijk is van perfecte datadiscipline in elke vestiging. Het platform vangt de inconsistenties op, stabiliseert de identiteit en maakt AI bruikbaar, ook als uw onderliggende systemen dat niet zijn.
Daarom zien klanten de nauwkeurigheid al verbeteren lang voordat ze hun hele datalandschap hebben opgeschoond.
Waarom dit belangrijk is
U kunt automatisering niet schalen zonder betrouwbare data. U kunt pilots lanceren. U kunt workflows bouwen. U kunt bestuurders imponeren met prototypes. Maar u kunt niet op netwerkniveau opereren zolang uw data geen structuur, ritme en betekenis heeft.
Volgende week sluiten we de serie af met de meetwaarde die er het meest toe doet: hoe u weet of uw balans tussen automatisering en menselijk contact echt werkt.
Klantervaring
Nieuwe reeks: de menselijke meerwaarde in het tijdperk van AI
In 2026 staan verkoopteams in automotive voor een grote verschuiving: klanten verwachten de snelheid van automatisering én de geruststelling van menselijk contact. Dit artikel introduceert de hybride klantreis in de verkoop, waarin AI zorgt voor timing, nauwkeurigheid en schaal, terwijl mensen vertrouwen, duidelijkheid en emotionele steun bieden. Dealerbedrijven en importeurs (NSC’s) die hun klantreis bewust ontwerpen, kunnen de conversie verhogen, relaties versterken en operationele wrijving verminderen. Week 1 legt de basis om te begrijpen bij welke contactmomenten automatisering, een combinatie of persoonlijk contact voorrang krijgt, en bereidt lezers voor op de tools, raamwerken en governancemodellen van de komende vijf weken.
Snellere doorstroming in het verkoopproces
Quoto: wat er gebeurt als uw offerte de koopervaring wordt
Dit artikel betoogt dat de offerte niet langer alleen een administratieve stap is, maar een cruciaal onderdeel van de koopervaring. Het laat zien hoe veel dealernetwerken momentum verliezen wanneer een geïnteresseerde klant slechts een pdf, spreadsheet of link naar de voorraad ontvangt in plaats van een heldere, professionele volgende stap. Het legt uit waarom dit zowel een conversieprobleem als een consistentieprobleem in het netwerk veroorzaakt, en positioneert Quoto als manier om de offerte om te zetten in een overzichtelijke offerte in de huisstijl van het merk, met één voertuig, één aanbod en één pad naar de beslissing. Het resultaat is een soepelere klantreis en sterkere uitvoering in het hele netwerk.
Leadmanagement
Facebook- en Instagram-leads automatisch kwalificeren voordat uw verkoopteam ze oppakt
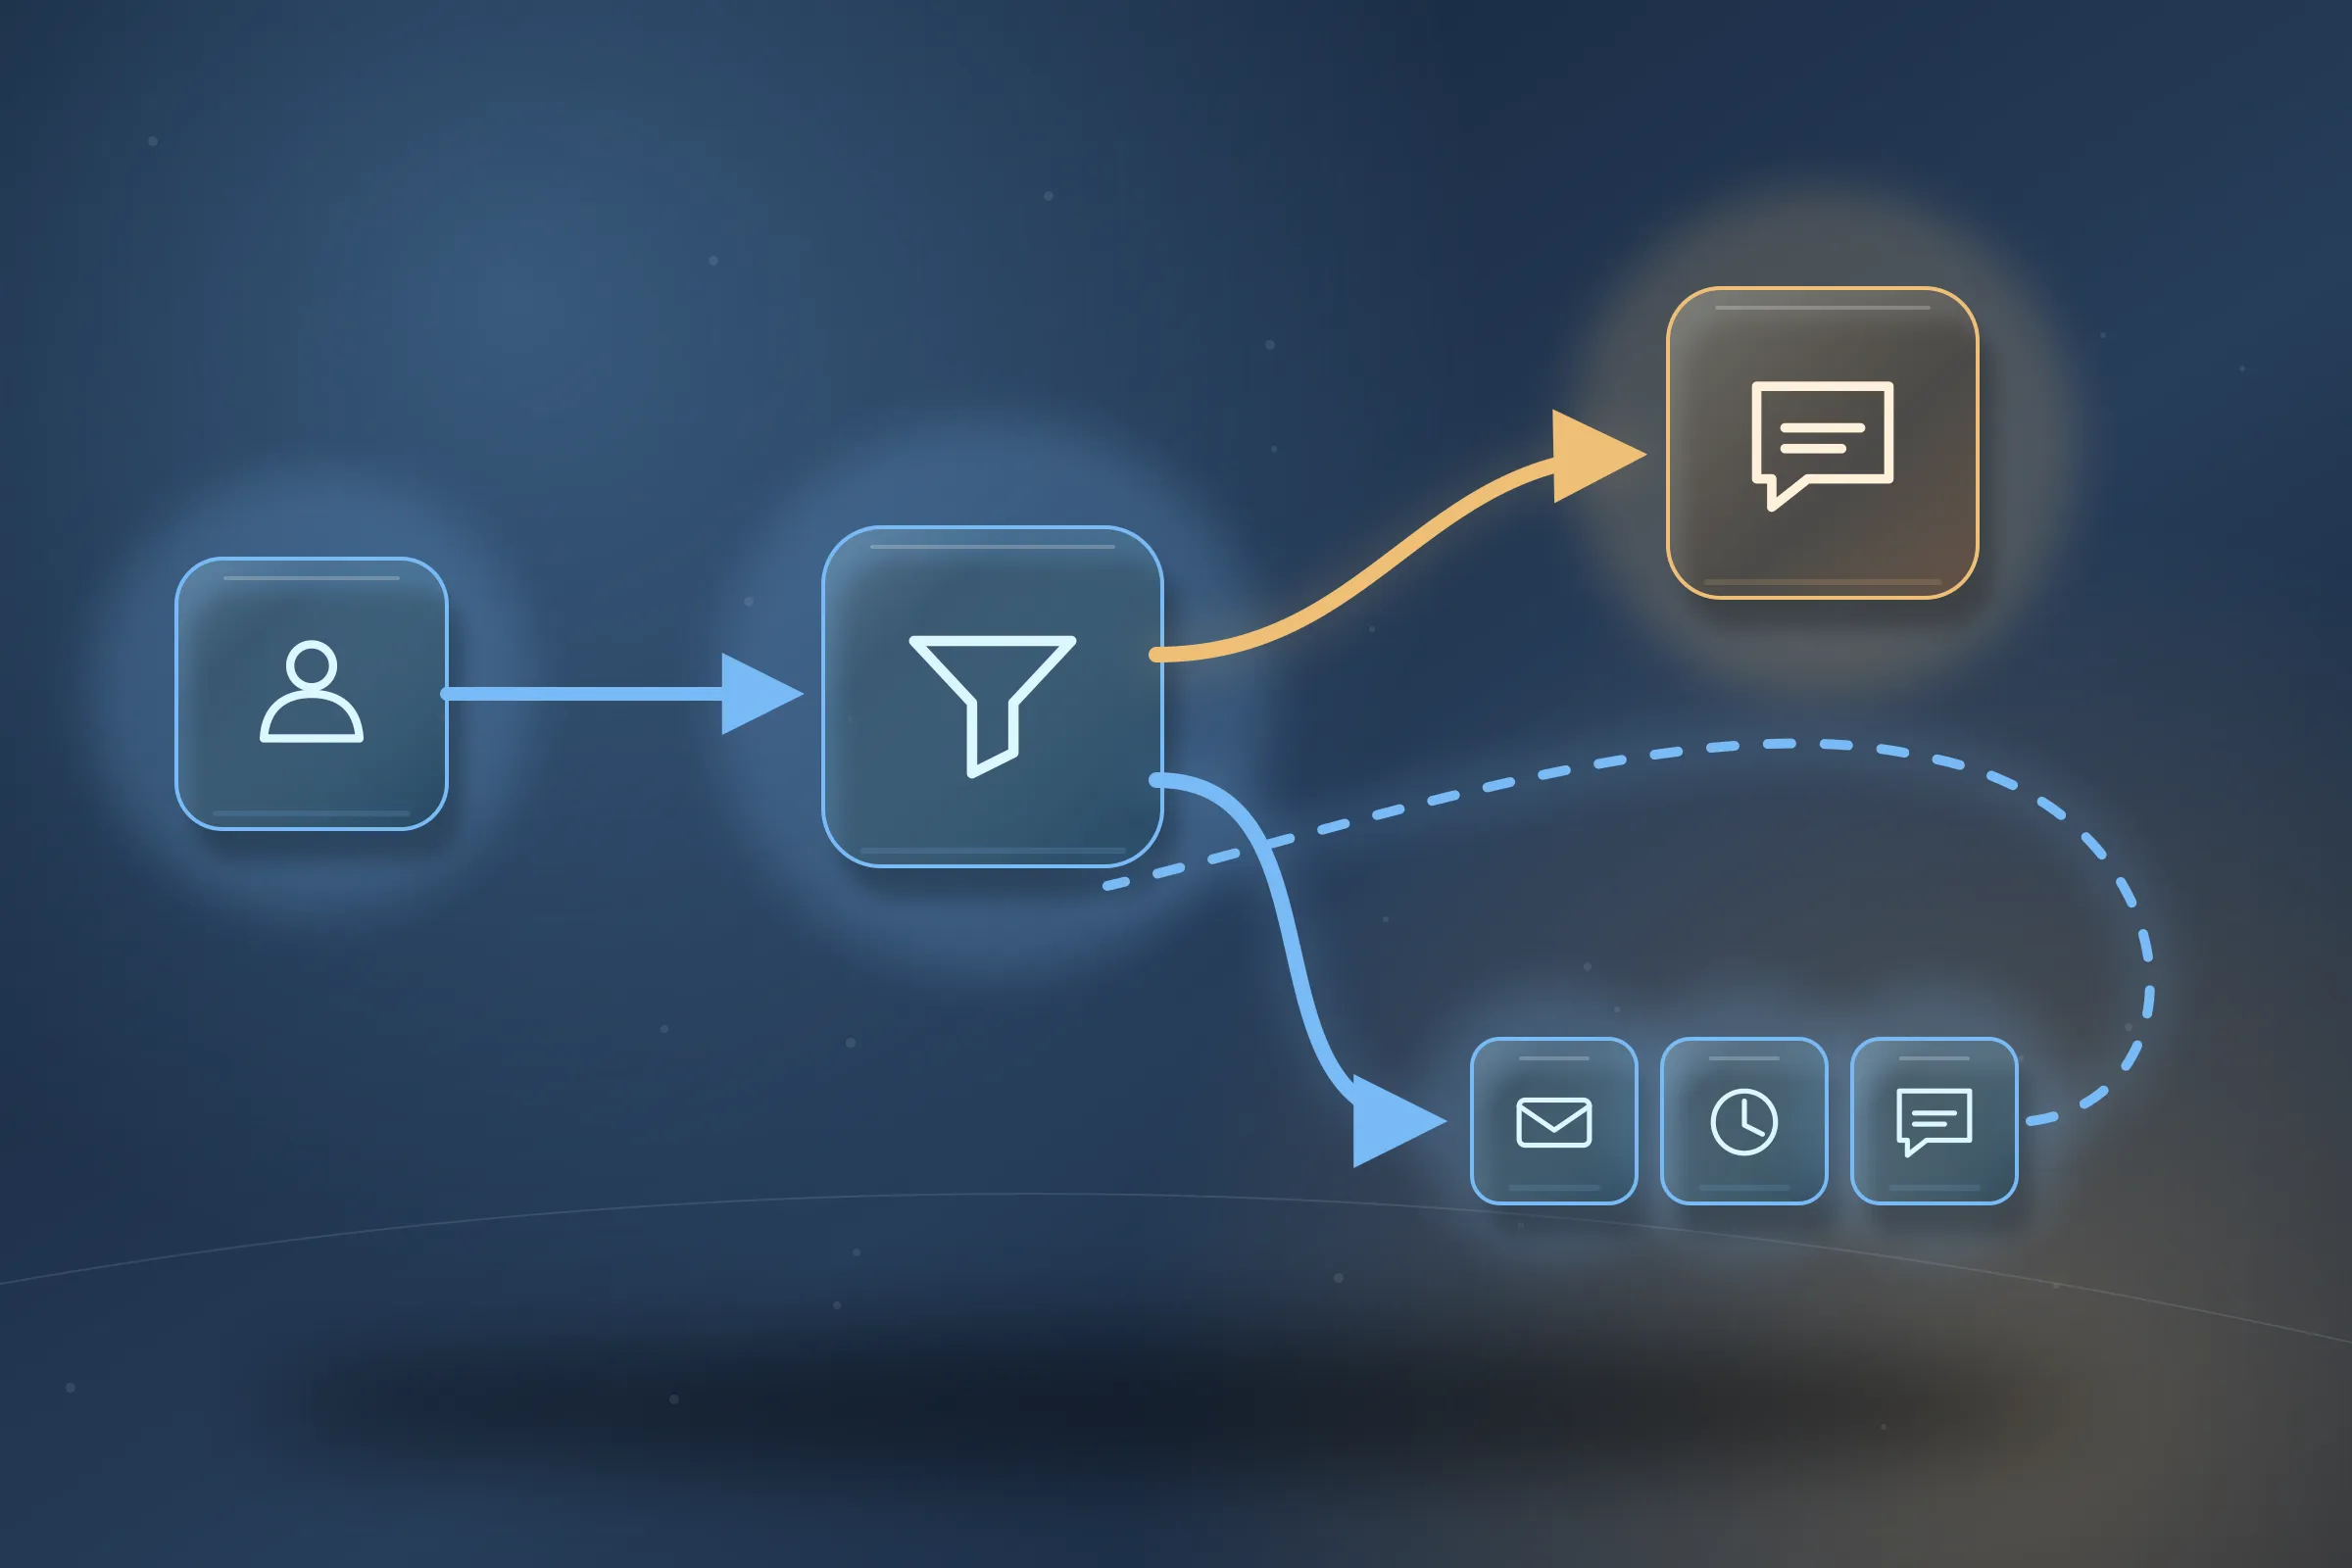
Meta-leads van Facebook en Instagram bevatten vaak mensen die zich nog oriënteren, en dat kan verkoopcapaciteit opslokken wanneer elke aanvraag wordt behandeld alsof ze klaar is voor verkoop. Dit artikel legt uit hoe u met WEBSOLVE Flows een automatische kwalificatielaag toevoegt. De aanpak: direct reageren, één korte bevestigingsvraag stellen om de intentie zichtbaar te maken, en leads die niet reageren met geautomatiseerde opvolging via e-mail, sms of WhatsApp betrokken houden tot ze weer in beweging komen. Betrokken prospects worden snel naar verkoop doorgezet, zodat verkopers spreken met mensen die echt een gesprek willen. Het resultaat: minder verspilde opvolging, snellere reactie waar het telt en een schoner pad van aanvraag naar gesprek.
Herkent u deze uitdaging in uw netwerk?
Leg ons de uitdaging voor. We vergelijken die met wat we in de praktijk hebben zien werken en stellen een zinvolle volgende stap voor.
Bespreek uw uitdagingEen gesprek van 30 minuten met een senior specialist.